DeepSeek 발표는 늘 숫자가 많습니다. 9월 10일 나온 DeepSeek-V4.1-Flash도 그랬는데, 저는 그 숫자들 사이에서 두 가지가 가장 흥미로웠습니다. 모델이 입력과 출력에 서로 다른 크기의 두뇌를 쓴다는 점, 그리고 한국 시간으로 저녁에 쓰면 API 요금이 절반이 된다는 점입니다. 공식 발표에 따르면 V4.1-Flash는 새 아키텍처 제품군에서 가장 작은 모델이고, 이미지를 기본으로 이해하는 멀티모달 모델입니다.
구조와 성능은 DeepSeek 공식 발표문과 API 변경 로그(2026-09-10), 가격은 DeepSeek API 문서의 Models & Pricing 페이지를 기준으로 했습니다. 벤치마크는 DeepSeek가 발표한 값입니다.
5,520억 개 중 일부만 깨어난다
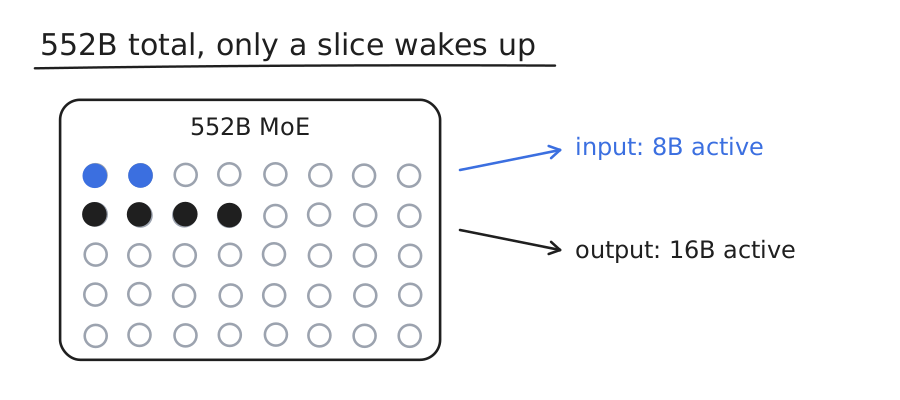
V4.1-Flash는 전체 5,520억 파라미터의 MoE(전문가 혼합) 모델입니다. 여기에 DeepSeek가 Causal Encoder–Decoder라고 부르는 새 구조를 얹었습니다. 입력을 읽을 때는 80억 개, 답을 만들 때는 160억 개 파라미터만 활성화됩니다. 읽는 일과 쓰는 일에 드는 힘을 다르게 나눈 셈이고, DeepSeek는 이를 비대칭 구조라고 부릅니다.
KV 캐시도 줄었습니다. 이전 세대보다 GPU 메모리(HBM)는 4분의 1, SSD 저장 공간은 8분의 1만 필요하다고 합니다. DeepSeek는 에이전트 작업 비용에서 캐시 적중 요금이 차지하는 비중이 커서, 캐시를 줄이면 비용이 크게 줄어든다고 설명합니다. 성능은 변경 로그 기준으로 GPQA Diamond 90.9, DeepSWE v1.1 74.2, Terminal-Bench 4.0 31.2, 도구를 쓴 HLE 63.9입니다. 여러 곳의 테스트에서 상위 모델 V4-Pro보다 성능, 비용, 속도가 앞섰다고도 밝혔습니다.
한국 시간으로 보면 요금표가 달라 보입니다
API 모델명은 deepseek-flash이고, 문맥 길이 100만 토큰, 최대 출력 38만 4천 토큰, 이미지 입력을 지원합니다. 이전 V4-Flash와 V4-Flash-Vision-Exp는 서비스를 끝냈고, 기존 이름으로 요청하면 당분간 V4.1-Flash가 Flash 요금으로 처리합니다. 새 가격은 9월 10일 04:00 UTC(한국 시간 13:00)부터 적용됐습니다.
피크 요금 기준 100만 토큰당 입력은 캐시 미적중 0.30달러, 캐시 적중 0.006달러이고 출력은 1.20달러입니다. 비피크에는 모두 절반입니다. 여기서 한국 사용자에게 중요한 건 피크 시간입니다. 가격 페이지의 피크는 평일 01:00–04:00, 06:00–10:00 UTC인데, 한국 시간으로 옮기면 평일 10:00–13:00, 15:00–19:00입니다. 그 밖의 시간과 주말, 중국 공휴일은 모두 비피크입니다.
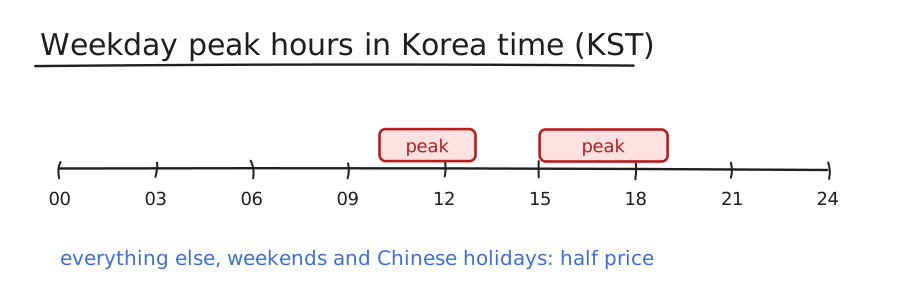
한국 업무 시간과 거의 겹친다는 뜻입니다. 저라면 급하지 않은 대량 작업은 저녁이나 주말에 돌리도록 스케줄을 짜겠습니다. 그것만으로 비용이 절반이 됩니다.
V4-Pro는 원래 계획과 달리 남았습니다
처음 발표문에는 9월 14일 04:00 UTC부터 모든 deepseek-v4-pro 요청을 V4.1-Flash로 넘기겠다고 적혀 있었습니다. 그런데 이후 API 변경 로그에서 방침이 바뀌었습니다. 사용자 요청에 따라 9월 14일 이후에도 V4-Pro API를 계속 제공하고 요금 방식도 그대로 둔다고 합니다. V4-Pro로 서비스를 만든 분이라면 변경 로그를 기준으로 삼으면 됩니다. 다음 상위 모델 V4.1-Pro는 예고만 됐고 날짜는 없습니다.
한국에서는?
DeepSeek는 API 공지에서 국가별 제공 범위를 밝히지 않았습니다. 한국 출시 여부는 발표되지 않았습니다. API에 국가 제한 문구는 없지만, 한국에서 가입과 결제가 되는지는 직접 확인해야 합니다. 앱에서 V4.1-Flash를 쓸 수 있는지도 이번 발표에는 나오지 않습니다.
큰 모델을 통째로 돌리지 않고 필요한 만큼만 깨우는 방식, 그리고 시간대별 요금. 두 가지 모두 결국 같은 질문에 대한 답처럼 보입니다. 같은 지능을 얼마나 싸게 공급할 수 있느냐는 질문입니다.
출처
- DeepSeek, “Introducing DeepSeek-V4.1-Flash: smarter, faster, more efficient.” (2026-09-10): https://www.deepseek.com/en/news/deepseek-v4-1-flash/
- DeepSeek API Docs, Change Log (2026-09-10 항목): https://api-docs.deepseek.com/updates
- DeepSeek API Docs, Models & Pricing: https://api-docs.deepseek.com/quick_start/pricing
댓글
GitHub 계정으로 의견을 남길 수 있습니다. 댓글은 GitHub Discussions에 저장됩니다.